
Pendant des décennies, la gestion des données de gestion opérationnelle (ERP) a souffert d’un cloisonnement technique majeur. L’extraction, la transformation et le chargement (ETL) vers des entrepôts de données externes exigeaient des tuyauteries complexes et coûteuses. Non seulement ces mécanismes alourdissaient les infrastructures, mais ils altéraient le contexte métier indispensable aux analyses décisionnelles. L’intégration récente de technologies Data Lakehouse performantes, comme celles portées par Dremio au sein de l’écosystème SAP, marque une rupture fondamentale pour libérer ces données sans déplacement inutile.
Modernisation des architectures ERP : le dépassement des tuyauteries ETL
La dette technique liée à la fragmentation des données d’entreprise
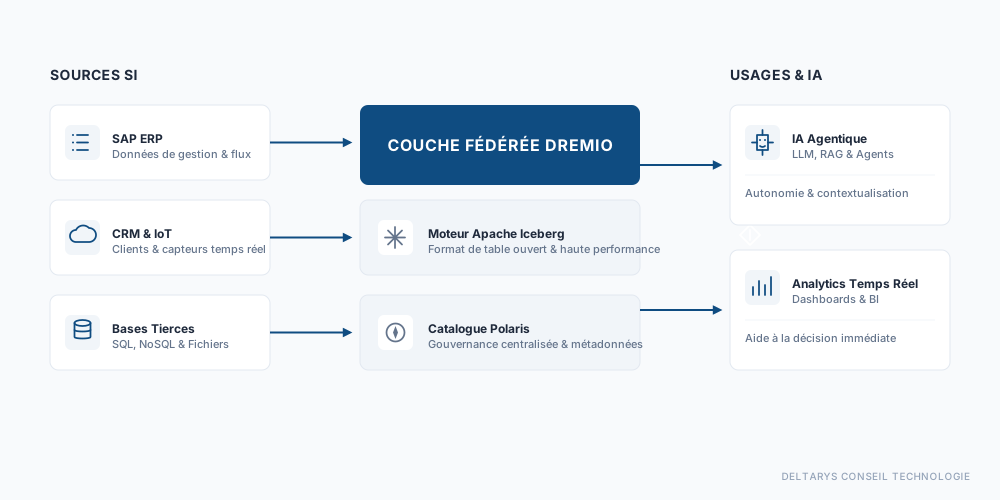
Dans la plupart des grandes organisations et des ETI, le système d’information ressemble à une mosaïque complexe. D’un côté, le cœur ERP orchestre la comptabilité, la finance et les flux logistiques. De l’autre, des CRM, des plateformes IoT et des bases décisionnelles tierces accumulent des téraoctets d’informations stratégiques. Historiquement, l’interconnexion de ces univers nécessitait des batchs nocturnes d’extraction. Cette approche entraînait deux problèmes majeurs : une latence élevée des données et la perte irrémédiable de la sémantique métier construite dans le progiciel.
À l’ère où l’automatisation s’impose comme un facteur de compétitivité, ces lenteurs deviennent un obstacle bloquant. Comme le rappelait fort justement Satya Nadella, PDG de Microsoft : « L’IA ne vaut que par la qualité et la disponibilité en temps réel des données sur lesquelles elle s’appuie. » Lorsque les données opérationnelles sont figées ou dupliquées, les algorithmes prédictifs perdent toute efficacité.
Le passage du stockage centralisé au requêtage fédéré
Pour contourner ce verrou, l’architecture d’entreprise évolue. Plutôt que de forcer la migration massive de toutes les informations vers un réceptacle unique, l’approche moderne privilégie la fédération de données. Le moteur de requêtage fédéré de Dremio permet d’interroger directement des sources distribuées à très haute performance, sans exiger de conversion préalable ni de réplication inutile. Cette capacité à analyser les informations là où elles résident simplifie radicalement l’architecture décisionnelle en remplaçant avantageusement les modèles complexes d’extraction SAP BW traditionnels.
L’impact stratégique de Dremio sur SAP Business Data Cloud
Le rôle pivot du format open source Apache Iceberg
La transformation de la solution SAP Business Data Cloud repose sur le choix d’un standard ouvert. En capitalisant sur le format de table Apache Iceberg et le catalogue d’entreprise Apache Polaris, SAP configure une plateforme décisionnelle moderne et hautement évolutive. Dremio y apporte une couche sémantique puissante combinée à un moteur d’exécution ultra-rapide.
Grâce à cette synergie, les entreprises ne sont plus enfermées dans des formats propriétaires. L’accès aux tables d’analyse se fait avec des performances comparables à celles d’un entrepôt de données relationnel traditionnel, tout en conservant la flexibilité d’un data lake cloud économique. Cette vision, formalisée dans la stratégie North Star Architecture de SAP, concrétise l’avènement du Data Lakehouse natif d’entreprise.
Accélérer l’IA agentique Joule au cœur des processus ERP
L’accès instantané aux données sans ETL ouvre la voie à l’IA agentique. Dans un système comme SAP S/4HANA Cloud, l’assistant autonome Joule ne se contente plus de répondre à des questions simples ou de générer des synthèses. Il devient capable d’exécuter des requêtes distribuées complexes et de déclencher des actions correctives en temps réel.
Par exemple, si un agent IA doit réévaluer un plan de production, il peut interroger simultanément la base opérationnelle HANA, les métriques IoT des usines stockées dans un data lake d’entreprise et les prévisions de demande d’un système externe. Sans la fédération zéro-ETL, ce type de décision prendrait des heures d’assemblage de fichiers ; avec un Data Lakehouse unifié, l’opération s’effectue en quelques secondes.
Analyse comparative : SAP face aux géants du Data Cloud
Préservation du contexte métier : un avantage concurrentiel décisif
La concurrence fait rage entre SAP et les leaders de la data que sont Snowflake, Databricks et Microsoft Fabric. Si ces plateformes tierces proposent des moteurs décisionnels très véloces, elles se heurtent souvent à un obstacle majeur : la perte du modèle de données de l’ERP lors de la réplication.
- SAP Business Data Cloud (avec Dremio) : zéro migration ETL requise pour les sources fédérées, conservation native du Knowledge Graph SAP et du contexte sémantique S/4HANA.
- Snowflake (Cortex / Iceberg) : performances élevées, mais nécessite la récréation manuelle des structures sémantiques et le chargement des données.
- Databricks (Unity Catalog / Delta Lake) : très puissant pour l’ingénierie de données et le Machine Learning, mais exige la reconstruction des pipelines pour préserver la sémantique ERP.
- Microsoft Fabric (OneLake) : très fluide au sein de l’écosystème Azure et Dynamics, mais nécessite des connecteurs spécifiques pour exploiter pleinement les données SAP.
Cas pratique : l’orchestration de la chaîne logistique en temps réel
Prenons le cas d’un équipementier industriel confronté à une rupture imprévue dans sa chaîne d’approvisionnement. Traditionnellement, le gestionnaire devait extraire les données d’inventaire de S/4HANA, télécharger les fichiers de géolocalisation des flux logistiques auprès des transporteurs, puis croiser ces éléments dans un tableau de bord analytique rechargé durant la nuit.
Grâce à l’architecture unifiée de SAP Business Data Cloud intégrant Dremio, l’agent IA Joule accède directement et en temps réel aux tables de commande de l’ERP et aux données externes de télémétrie des transporteurs. En interrogeant ces sources sans déplacement de données, l’agent détecte le retard, identifie un fournisseur alternatif disponible dans le système et propose immédiatement une réaffectation des stocks. L’ensemble du processus décisionnel, autrefois fragmenté sur plusieurs jours, se résout en un clic tout en maintenant une gouvernance parfaite des données d’entreprise.
Sources
- SAP Business Data Cloud – SAP Community
- Heralding the Autonomous Enterprise: what does SAP’s North … – Expertum (25 août 2026)
- Apache Iceberg – Apache Iceberg™ – Apache Software Foundation
- Logiciel ERP cloud SAP S/4HANA pour les entreprises en … – SAP
- The Best Semantic Layer Tools in 2026: A Buyer’s Guide – ER/Studio (10 juil. 2026)
- SAP is Rebuilding the Enterprise Data Plane Around … – Medium · vinay kumar
Besoin d accompagnement sur ce sujet ?
Vous faites face a une problematique similaire dans votre organisation ? Fort de plus de 20 ans d experience dans l accompagnement des directions financieres, DAF, DSI et directions achats dans leurs projets de transformation, je serai heureux d echanger avec vous. Exposez votre problematique via notre page de contact et je vous recontacterai personnellement.
À lire aussi
- Sage rachète Paperless Environments : la guerre du Cloud ERP BTP est déclarée face à Procore, Trimble et Acumatica
- Lancement d’Accenture Construct : la réinvention du conseil en gestion de grands projets et data centers IA
- Conseil et transformation d’entreprise : l’expansion transatlantique s’accélère avec le rachat de Sand Cherry par Wavestone
- Fin du support des ERP historiques : comment SAP, Oracle et Microsoft imposent le virage vers le Cloud